Презентация в pdf | Презентация в pptx
Large Language Model (большая языковая модель) —программа, которая предсказывает последующее слово в тексте. LLM обучена на огромных корпусах текста, умеет продолжать текст, перефразировать, переводить, отвечать на вопросы.
Она не «знает» и не «понимает» мир напрямую, а лишь опирается на статистико-вероятностные закономерности языка и на тексты, которые этот мир описывают.
Получив чанк (кусок) текста (контекст), модель оценивает вероятность каждого возможного следующего токена(части слова); затем выбирает один наиболее вероятный и повторяет процесс, строя ответ шаг за шагом.
Технически это выглядит так: на вход модели подается последовательность токенов, на выходе получает распределение вероятностей по словарю токенов и результат в виде связного текста.
Текст → Токенизация→ Embeddings → Блоки Transformer с Attention → Softmax → Выбор следующего токена → Цепочка токенов → Итоговый текст
Пример: «Сегодня погода очень …» → вероятности: «теплая» 0.42, «хорошая» 0.25, «плохая» 0.08, … → выбор токена → «теплая».
Как выглядит процесс генерации текста
Исходный промпт(Prompt): «В темном лесу путник нашел…»
1. Токенизация:
Фраза разбивается на токены: [«В», «темном», «лесу», «путник», «нашел», «…»]
Токен «…»—это позиция, которую нужно предсказать.
2. Embeddings и Блоки Transformer:
Модель анализирует контекст: «темный лес», «путник», «нашел». Активирует связи с темами: страх, опасность, магия, сокровище, тайна.
3. Softmax-слой выдает распределение вероятностей для следующего токена:
(А) Продолжение в жанре фэнтези / сказки:
«старинный»(P = 0.31)
«волшебный» (P = 0.28)
«сияющий» (P = 0.10)
(Б) Продолжение в жанре хоррора / триллера:
«странный» (P = 0.15)
«окровавленный» (P = 0.08)
«забытый» (P = 0.05)
(В) Прямое и нейтральное продолжение:
«дорогу» (P = 0.02) или «грибы» (P = 0.01)
4. Продолжаем предложение:
«…нашел старинный»:
«сундук» (P = 0.40)
«артефакт» (P = 0.25)
«меч» (P = 0.15)
«свиток» (P = 0.10)
«дом» (P = 0.01)
5. В итоге получаем: «В темном лесу путник нашел старинный сундук«
Вопрос: почему это работает?
Перевод: современные крупные языковые модели (LLM) учатся на огромном массиве параллельных и монологических данных, умеют обобщить языковую информацию, сохраняют стиль и контекст, и могут адаптироваться под задачи перевода без явной программы-правил; вместо правил или языка посредника работают вероятностно-статистические методы на основе больших массивов текстовой информации +возможности обработки в трансформере.
Ответы на вопросы и рассуждения: модель видела множество образцов объяснений и логических ходов; при генерации она продолжает те шаблоны, которые статистически связаны с данным запросом.
Планирование и стиль: задавая инструкцию (роль, тон, формат), мы смещаем распределение вероятностей к нужным шаблонам.
Вопрос: почему часто работает криво?
Нет реального «понимания» как у человека, нет приобретаемого опыта и порождаемых в связи с познанием смыслов —есть лишь статистическая аппроксимация того, как пишут о мире, причем на конкретных языках.
Галлюцинации: возможны уверенные, но неверные утверждения. ИИ уверенно выдумывает факты, а будучи пойман, продолжает сочинять небылицы. Поэтому лучше с LLM работать как со студентами: сначала обучимодель, потом задавай свой запрос в виде подробной инструкции (промпт).
Чувствительность к формулировке: иной контекст (промпт) → новое распределение вероятностей → иной ответ.
Контекстное окно ограничено: модель учитывает лишь часть истории диалога/текста с пользователем, особенно бесплатные версии.
Не гарантирует точную терминологию/реалии без проверки. Лучше заранее задать глоссарий, и все равно проверять и перепроверять в постредактировании.
Этические вопросы: авторские права, предвзятость данных.
Как проходит обучение LLM?
Цель обучения модели: минимизировать ошибку предсказания следующего токена, i.e. разницу между предсказанным токеном и реальным (cross-entropy).
Данные: большие корпуса (книги, статьи, сайты). Обучается обычно на миллиардах примеров «контекст → следующий токен»
Поскольку англоязычных текстов больше всего в обучении LLM, основные европейские и американские модели владеют лучше английским. А YandexGPTи Алиса –русским.
После базового обучения добавляют:
Инструкционное дообучение(пример: «вопрос → хороший ответ»).
RLHF: люди сравнивают или редактируют ответы, модель учится предпочитать более полезные и безопасные.
При переводе специализированных текстов лучше предобучить модель на проверенных (параллельных) корпусах/массивах, можно снабдить глоссарием, чтобы перевод был точнее.
Вопрос: какие ИИ эффективнее использовать в переводе?
БЕСПЛАТНЫЕ и ДОСТУПНЫЕ ОЧЕНЬ НАС РАДУЮТ:
- DeepSeek (深度求索)
- Mistral (Le Chat)
- Qwen (Alibaba, 通义千问)
- YandexGPT и Алиса ChatGPT4o (OpenAI в ТГ)
- GigaChat (от Сбера)
- Gemini (Google)
- Perplexity (США)
А ЭТИ не радуют: они либо недоступны в РФ, либо платные. Платно их можно заполучить через аггрегаторы за деньги, НО можно найти более простые бесплатные версии в ТГ: Bing (Microsoft), ChatGPT5 (OpenAI), Claude(США Anthropic), Grok (Твиттер/Х), DeePl (уж недоступен), Llama (Meta, сорри гайз)
Вопрос: есть ли зависимость по тематике?
Да. См. таблицу ниже.
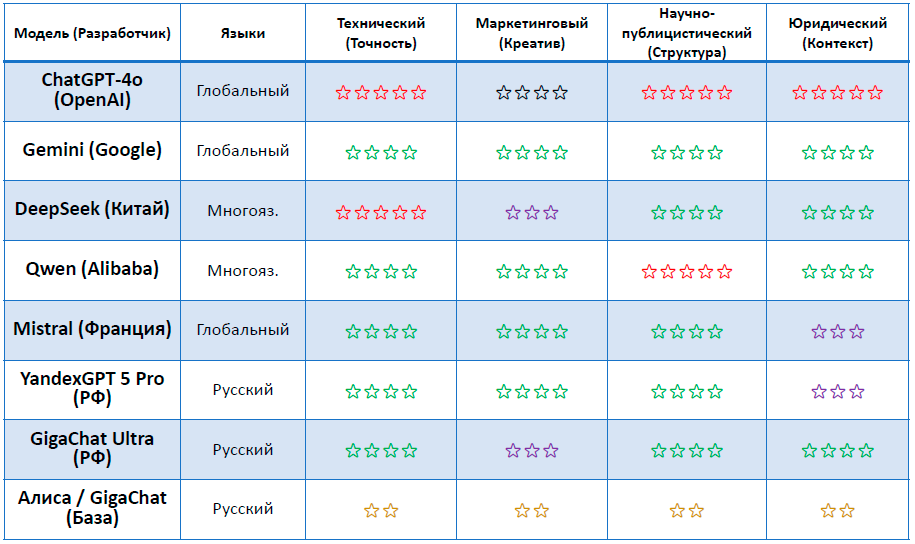
Для технических и юридических переводов точность и сохранение структуры документа: ChatGPT-4o или DeepSeek-R1 DeepSeekсилен в логике и коде, GPT-4o —в сложных юридических формулировках и длинных контекстах. GigaChatPro также подходит для русскоязычных юридических документов, так как натренирован на российском правовом поле.
Для маркетинговых и креативных переводов адаптация тона, культурного контекста и живость языка: Gemini или Mistral хорошо справляются с креативом и естественным звучанием на разных языках. YandexGPTиАлиса Pro отлично адаптируют тексты под российскую культуру и сленг.
Для научно-публицистических текстов способность обрабатывать большие объемы текста и сохранять академический стиль: Qwen хорош в обработке и подредактировании длинных текстов (до 128К+ токенов) и поддержке множества языков. GPT-4o и GigaChat неплохи в работе с научным стилем; могут редактировать в соответствии с заданными стандартами.
Вопрос: есть ли зависимость по языкам и направлению перевода?
Да. Качество перевода напрямую зависит от того, на каком объеме данных модель обучалась для конкретной языковой пары.
Доминирование английского. Крупные мировые LLM–ChatGPT, Gemini, Claude, Qwen, and Mistralобучены на англоязычных текстах.Поэтому переводы, где английский язык оригинала (Source Language), либо целевой язык (Target Language), как правило, имеют качество выше. Английский <-> Испанский <-> немецкий лучше использовать мировые LLM, испанский <-> французский <->английский – Mistral неплох
Преимущество российских моделей в переводе на русский и языки СНГ.
Модели, разработанные в России, такие как YandexGPTи GigaChat, обучались на значительно большем объеме русскоязычного контента, чем их западные или азиатские конкуренты. В парах Английский -> русский или Русский <-> языки СНГ эти модели часто показывают более естественный, точный и контекстно-зависимый результат. Они лучше улавливают идиомы и клише.
В направлении Русский -> английский (и др. европейские) лучше использовать смешанные модели: например Gemini+Qwen+Mistral+YaTranslate и смотреть, у кого лучше получается. Для редких языковых пар данных мало (например, суахили, тагалог, диалекты), здесь качество перевода у всех моделей падает. В этом случае помогут только крупные LLM типа GPT, и то с трудом: понадобится языковая догадка и шерлокхомское изобретательство. Идем в Google.Translate и не кошмарим зря модели.
Вопрос: почему Яндекс переводчик часто лучше Гугла?
Яндекс не лучше, он другой. Яндекс выигрывает в парах с русским и другими славянскими языками, потому что:
Родной контекст: Яша изначально обучался на огромных массивах текстов из Рунета, поэтому лучше понимает специфический культурный контекст, сленг и реалии, которые для Google остаются «белым пятном», он «узнает» названия, которые для Google просто набор слов; поэтому перевод на русский у Я. порой звучит естественнее.
Сложная грамматика. Русский язык богат на падежи, склонения и свободный порядок слов. Алгоритмы Яндекса (благодаря словарю Зализняка) заточены под эти особенности, тогда как Googleчасто строит фразы по более жестким англоязычным шаблонам.
Гибридный подход. Яндекс использует сочетание нейросетевого, статистического перевода и LLM (интегрируя YandexGPT для постобработки). Статистический (SMT) переводит фразы по частям, что помогает избежать пропусков слов, а нейросетевой(NMT) анализирует предложение целиком, отвечая за естественность и «красоту». Специальный алгоритм-классификатор (на базе CatBoost) выбирает лучший из двух вариантов, позволяя сервису не просто подбирать слова, а «достраивать» смысл предложения, сохраняя естественность.
Специализация на кириллице. Сервис точнее работает с языками на основе кириллицы и славянской морфологией в целом, так как это его приоритетное направление развития.
Google сохраняет лидерство за счет глобального охвата:
Google поддерживает 130+ языков, Яндекс около 90. Это делает Google незаменимым при работе с редкими диалектами и языками. Он демонстрирует лучше результаты на «мировых» языковых парах(англ–испили англ–китайск).
Google выигрывает в парах русский язык + менее распространенные языки. Яндекс часто переводит «редкий язык → английский → русский», и множит ошибки, Googleстремится к более прямым нейросетевымсвязям. В паре с китайским, японским или корейским Googleчасто показывает более устойчивые результаты при переводе с русского, т.к. дольше и агрессивнее развивал азиатские сегменты своих нейросетей.
Google точнее передает терминологию в узких нишах: IT и программирование, т.к. обучается на огромных массивах англоязычной документации и кода, и лучше понимает контекст терминов, которые еще не успели массово войти в русский обиход. Международное право: в официальных формулировках ООН или ЕС точнее подбирает стандартные эквиваленты.
Новые AI-функции (2026): инструменты для изменения тона и стилистики текста (формальный, повседневный, упрощенный) в процессе перевода.
Эффективные промпты для перевода см. тут